分布式缓存一致性保障 那些踩过坑才懂的真实取舍
上周跟个做电商的老朋友在咖啡馆碰了面,他刚从大促的值班状态里缓过来,眼下的黑青还没消。
他说大促零点的时候,有个用户付完款,刷新订单页,缓存里还挂着”待支付”的状态。用户反复点了三次支付,扣了三次钱。客服后台的消息直接堆了几百条。
折腾到凌晨三点,才发现是缓存更新的链路卡了一下,旧值没刷掉。
分布式系统缓存与数据库写入时序冲突示意图 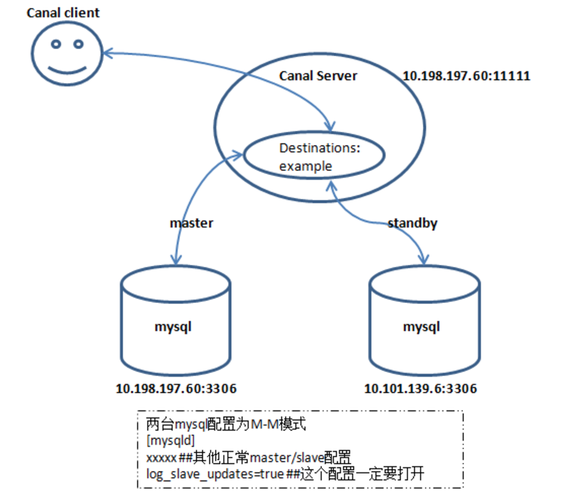
基于Canal的缓存异步更新链路流程图
别上来就追求绝对一致
很多人一碰到缓存和数据库不一致的问题,第一反应就是要做”强一致”。 纯属想多了。 分布式环境下,网络是不可靠的,机器是会出问题的,你凭什么觉得两次跨节点的写操作,能永远保持严丝合缝的顺序? 大家熟到不能再熟的”先更数据库,再删缓存”的方案,本来是能覆盖90%的场景的。但架不住有个边角情况:你刚把数据库的值更新完,还没来得及走到删缓存的那一步,刚好有个读请求打进来,发现缓存里的值还在,就把旧值读出来,重新写回了缓存。 哦,这就麻烦了。 这个旧值会一直在缓存里待着,直到你设的过期时间到了才会被清掉。这中间哪怕你把数据库改了十次,缓存里还是最开始的那个老值。 我第一次碰到这个bug的时候,盯着监控看了三个小时,后背全是冷汗。那些被过度神化的方案
后来有人说,别自己删缓存了,直接订阅数据库的binlog,异步把缓存的更新动作做了不就稳了? 这话听着确实顺。毕竟binlog是数据库本地生成的,只要链路是通的,总能把更新事件传出去。 但binlog同步的链路天生就有秒级延迟。 你拿这个做个博客系统、做个商品的详情展示页,可能没啥问题。毕竟内容改了之后,晚个两秒显示,用户根本感知不到。 你拿这个做交易场景试试? 用户刚付完款,binlog还在消息队列里排着队,缓存里还显示”未支付”,用户手指一哆嗦,又点了一次支付。